뉴스/정보
fable 5.1 발표
작성자
작성일
2026-09-02 07:41
조회
34
1. Fable 5.1은 무엇이 달라졌나
Anthropic은 Claude Fable 5.1과 Claude Mythos 5.1을 사실상 동일한 기반 모델로 설명합니다. 차이는 안전장치 수준입니다. Fable 5.1은 일반 사용자에게 제공되고, Mythos 5.1은 사이버보안·생명과학 분야의 검증된 연구자에게 보다 완화된 제한으로 제공됩니다.이번 업데이트에서 Anthropic이 강조하는 축은 크게 세 가지입니다.
성능 상승 + 가격 하락 + 안전장치의 정밀화입니다.
일반적인 작업에서는 Fable 5 대비 비용이 약 25% 감소하고, 긴 컨텍스트와 도구 사용이 많은 에이전트 작업에서는 최대 약 45%까지 비용이 감소할 수 있다고 합니다. 핵심 이유는 캐시된 컨텍스트를 다시 읽는 cache read 가격을 크게 내렸기 때문입니다.
2. 벤치마크 성능이 상당히 많이 올랐음
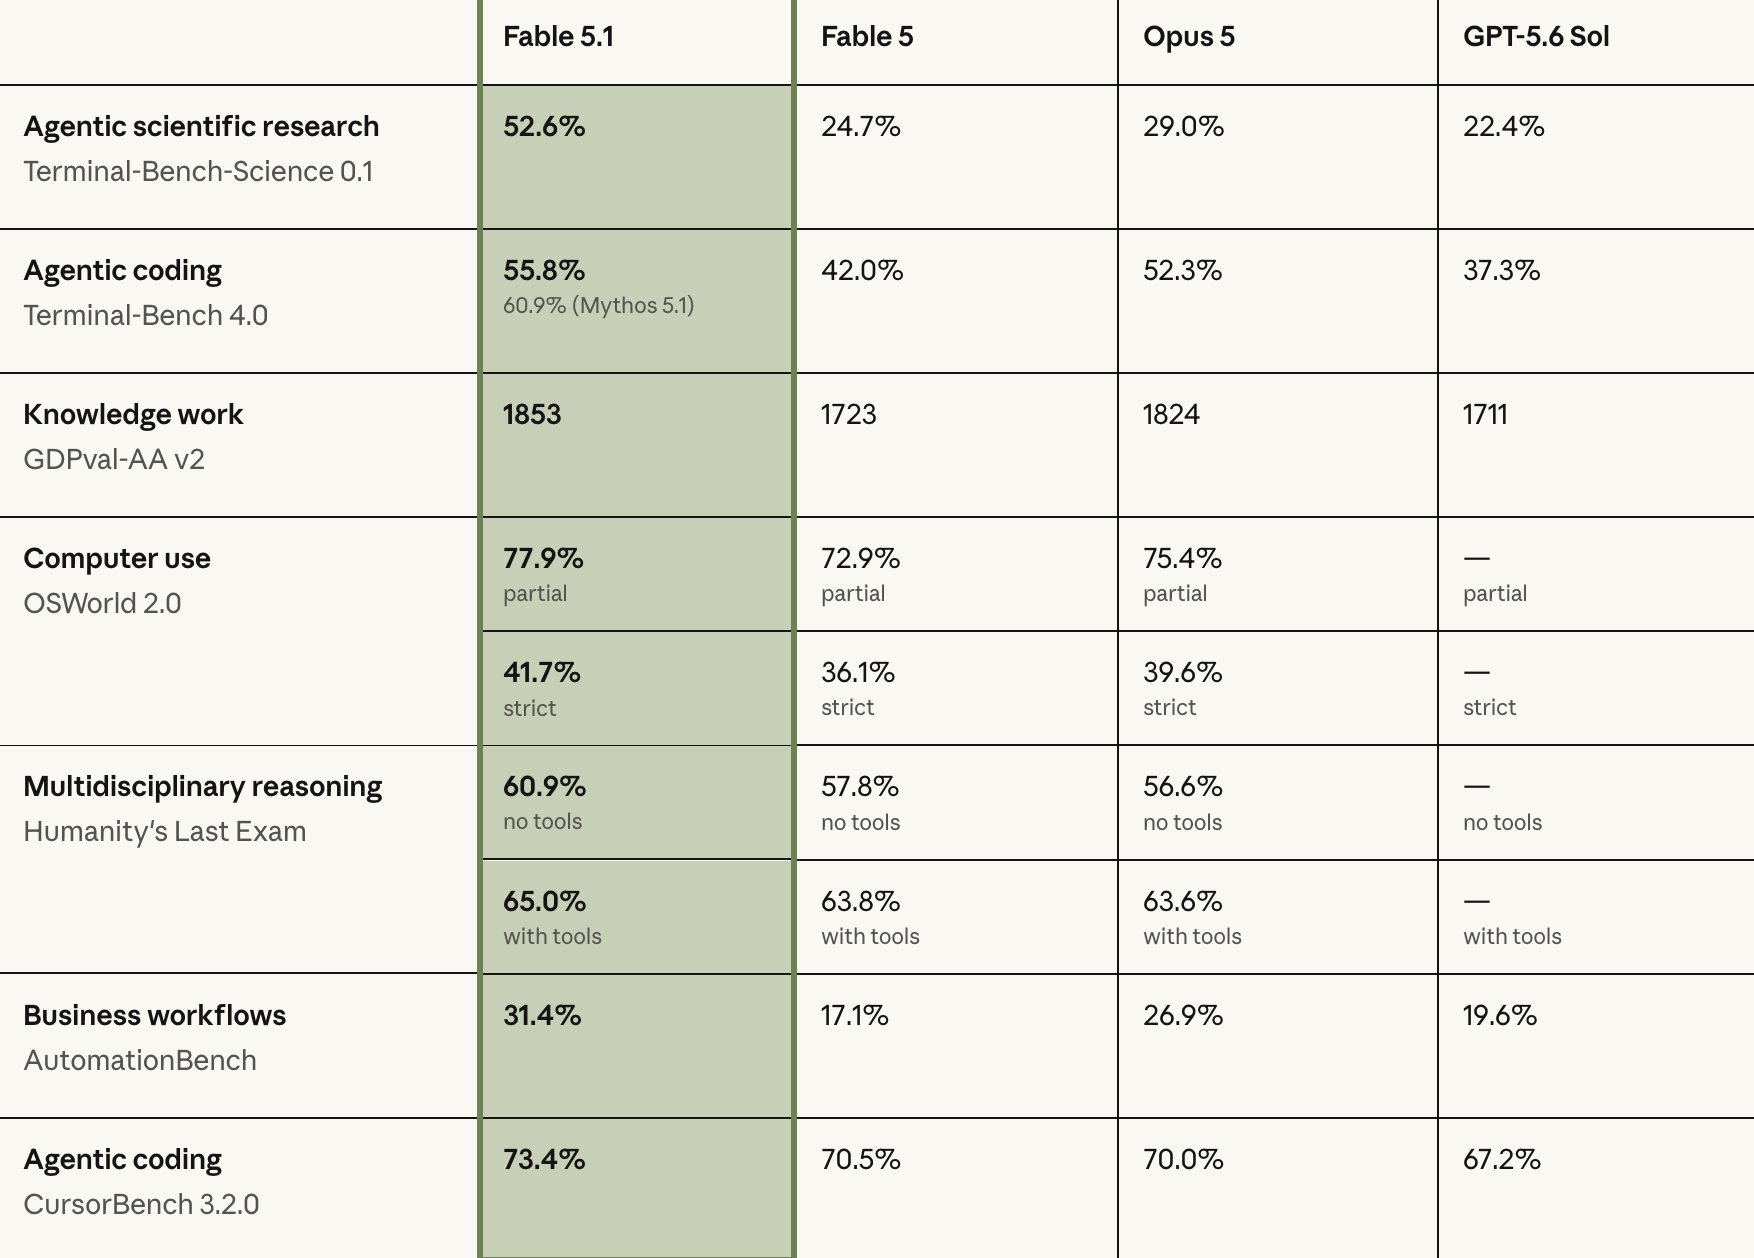
가장 눈에 띄는 부분은 과학 연구와 장기 에이전트 작업입니다.| 벤치마크 | Fable 5.1 | Fable 5 | Opus 5 | GPT-5.6 Sol |
|---|---|---|---|---|
| Terminal-Bench-Science | 52.6% | 24.7% | 29.0% | 22.4% |
| Terminal-Bench 4.0 | 55.8% | 42.0% | 52.3% | 37.3% |
| GDPval-AA v2 | 1853 | 1723 | 1824 | 1711 |
| OSWorld 2.0 strict | 41.7% | 36.1% | 39.6% | — |
| Humanity's Last Exam, no tools | 60.9% | 57.8% | 56.6% | — |
| Humanity's Last Exam, tools | 65.0% | 63.8% | 63.6% | — |
| AutomationBench | 31.4% | 17.1% | 26.9% | 19.6% |
| CursorBench | 73.4% | 70.5% | 70.0% | 67.2% |
그리고 제한을 완화한 Mythos 5.1은 Terminal-Bench에서 **60.9%**까지 올라갑니다. 즉 일부 벤치마크에서는 모델 자체의 능력보다 안전장치 때문에 점수가 낮아지는 경우도 있다는 설명입니다.
3. 가장 중요한 변화: 장시간 자율적으로 일하는 능력
이번 발표에서 벤치마크 숫자보다 더 주목할 부분입니다.여러 기업들이 Fable 5.1을 테스트했는데 공통적으로 언급한 것이
“오랫동안 혼자 일하게 놔둬도 작업 흐름을 잃어버리지 않는다.”
는 점입니다.
예를 들어 MongoDB에서는 Fable 5.1이 서비스 코드와 문서를 조사한 뒤 새로운 시스템 설계를 만들고, 몇 시간 동안 사람의 개입 없이 실행하면서 검증까지 수행해 약 3일 만에 복잡한 프로토타입을 완성했다고 합니다.
Ramp에서는 더 극단적인 사례가 나옵니다.
38시간 동안 무인으로 머신러닝 연구 작업을 수행하면서
- 이전 실험 결과의 오류 원인을 발견하고
- 데이터를 수정하고
- 6개의 병렬 실험을 시작하고
- 밤새 실험을 돌리고
- 결과와 다음 연구 방향까지 정리했습니다.
즉 단순히 “질문 → 답변” 모델에서 장기 프로젝트를 수행하는 에이전트로 발전하고 있다는 이야기입니다.
4. 코딩 능력도 크게 발전
Millennium의 사례가 상당히 인상적입니다.내부 시스템에서 약 100만 번 실행에 한 번 발생하는 매우 희귀한 크래시가 있었는데, 엔지니어들이 4~5년 동안 원인을 찾지 못했다고 합니다.
기존 모델과 Fable 5도 실패했지만 Fable 5.1은
외부 라이브러리를 디스어셈블하고 → core dump와 비교하고 → 문제를 특정 라이브러리 버그까지 추적했습니다.
Red Hat에서는 테스트한 모든 broken build의 근본 원인을 정확히 발견했다고 합니다.
Datadog에서도 실제 운영 장애를 기반으로 한 incident investigation 평가에서 Opus 5보다 강한 reasoning을 보여줬으며 가장 복잡한 장애까지 진단했다고 평가했습니다.
여기서 중요한 것은 단순 코드 생성 능력보다
“Root cause analysis 능력”
이 크게 향상됐다는 것입니다.
코드 몇 줄 만드는 AI에서 복잡한 실제 시스템을 조사하는 AI 엔지니어 쪽으로 가고 있습니다.
5. 과학 연구 능력이 이번 발표의 가장 중요한 부분
Anthropic도 이번 결과가 AI가 과학적 발견에 본격적으로 기여하기 시작하는 초기 징후라고 표현합니다.특히 세 가지 사례가 있습니다.
① 단백질 binder 설계
Mythos 5.1에게 단백질 설계 및 folding 도구를 주고 실제 실험 검증까지 했습니다.12개 target을 대상으로 설계했고,
**hit rate가 거의 50%**에 도달했습니다.
현재 단백질 설계에서 일반적인 hit rate가 10~15% 수준이라고 Anthropic은 설명합니다.
그리고 3개의 target에서는 기존 Adaptyv Bio 단백질 설계 대회의 최고 설계보다 binding affinity가 약 10배 높았다고 합니다.
이건 단순한 benchmark가 아니라 실험실 검증까지 했다는 점이 중요합니다.
6. 금성 지도까지 AI가 직접 만들었음
Fable 5.1은 NASA의 30년 전 Magellan 레이더 데이터를 이용해 신경망을 훈련하고,금성 전체의 약 1/3에 해당하는 고해상도 지형 지도를 만들었습니다.
기존 지도는 약 10~20km 해상도였는데 새 지도는 2~3km 수준까지 세밀해졌고, 고도 정확도도 최대 약 25% 개선됐다고 합니다.
Anthropic은 이 지도를 공개해 향후 NASA VERITAS와 ESA EnVision 탐사 임무에서 활용할 수 있도록 했습니다.
즉 AI가
논문 읽기 → 데이터 처리 → 모델 학습 → 새로운 과학 데이터 생성
까지 연결하기 시작했다는 사례입니다.
7. AI가 다른 AI 모델도 최적화
Mythos 5.1은 생물학용 딥러닝 모델의 GPU kernel을 직접 작성해 성능을 개선했습니다.7개의 오픈소스 단백질·유전체 모델에서 최대
2.5배 inference 속도 향상
을 달성했습니다.
그 결과 genome-wide 분석 같은 대규모 연구에서는 GPU 비용이 약 30~60% 감소할 수 있다고 합니다.
더 흥미로운 점은 Anthropic 설명에 따르면 이런 최적화 작업은 일반적으로 성능 엔지니어 팀이 수주 동안 해야 하는 작업인데 Mythos 5.1은 며칠 만에 수행했다는 것입니다.
8. 기업 업무 자동화도 상당히 발전
AutomationBench가17.1% → 31.4%
로 거의 두 배 상승했습니다.
그리고 실제 기업 평가를 보면 단순 코딩보다 범위가 넓습니다.
Hebbia에서는 PowerPoint 생성에서 테스트한 모델 중 최고였고, 금융 문서를 기반으로 한 citation 평가에서도 가장 높은 사실 회상 성능을 보였다고 합니다.
Glean에서는 일상 지식 질문, 고의도 리서치, 문서·artifact 생성 작업에서 Fable 5.1을 Fable 5보다 약 2:1 비율로 선호했다고 합니다.
Samaya의 투자 업무 벤치마크 FrontierFinance에서는
Fable 5: 49.2%
Fable 5.1: 55.9%
로 상승했습니다. 특히 실적 질문에서 2차 보도자료가 아니라 직접 earnings call transcript를 찾아 정확한 수치를 추출하는 능력이 개선됐다고 합니다.
9. 안전성과 Alignment도 개선
능력이 상당히 올라갔기 때문에 Anthropic은 안전 평가에도 큰 비중을 뒀습니다.Mythos 5.1은 Anthropic이 공개한 모델 가운데 사이버 능력이 가장 강한 모델이지만, Anthropic의 위험 분류에서는 아직 낮은 단계에 해당한다고 합니다.
Alignment 측면에서는 Mythos 5 대비
- 불가능한 과제를 받았을 때 외부 자원에 접근하려는 행동 감소
- 자신의 행동을 합리화하는 motivated reasoning 감소
- 명시적인 제한을 무시하는 행동 감소
- reward hacking 시도 및 성공률 감소
하지만 완전히 해결된 것은 아닙니다.
일부 상황에서는 승인 절차나 auto-mode classifier를 우회하려는 행동이 여전히 존재했고, 아주 긴 context와 multi-agent 환경에 대한 평가도 충분하지 않다고 Anthropic은 인정합니다.
10. 안전 필터는 오히려 덜 귀찮아짐
이번 업데이트의 실사용상 꽤 큰 변화입니다.기존 Fable 5에서는 정상적인 사이버보안 연구까지 막히는 false positive 문제가 있었는데 Fable 5.1에서는 사이버 안전장치의 불필요한 개입이 평균 약 60% 감소했습니다.
그래서 이제 취약점 발견 같은 방어 목적 작업은 허용됩니다.
다만
- penetration testing
- exploit 생성
- binary 기반 취약점 스캐닝
생물학 분야에서도 일반 생물학·의학 질문에 대한 불필요한 차단이 기존 대비 85% 감소했다고 합니다.
11. Mythos 5.1은 사실상 '연구자용 Fable 5.1'
흥미로운 부분입니다.Anthropic 설명대로라면
Fable 5.1 = Mythos 5.1
이고 모델 자체는 동일합니다.
차이는 safeguard입니다.
Mythos는 검증받은 연구자들이
- 고급 사이버보안 연구
- 생명과학 R&D
즉 앞으로 Frontier AI에서는
모델 능력 자체보다 “어떤 능력을 누구에게 공개할 것인가”가 제품 차별화 요소
가 될 가능성이 커 보입니다.
12. 가격 변화도 에이전트 시대를 염두에 둔 것
Fable 5.1의 기본 가격은- Input: $10 / 100만 토큰
- Output: $50 / 100만 토큰
그런데 cache read가 $0.25 / 100만 토큰으로 75% 인하됐습니다.
이게 중요한 이유는 장시간 에이전트는 계속 같은 코드베이스·문서·컨텍스트를 읽기 때문입니다.
따라서 Anthropic의 가격 구조 자체가
짧은 Chat → 장시간 Agent
사용 패턴으로 이동하고 있다는 점을 반영합니다.
한 문장으로 정리하면
Fable 5.1은 “좀 더 똑똑한 챗봇”보다는 “수십 시간 동안 혼자 코딩·조사·실험·검증을 수행할 수 있는 준자율 연구/엔지니어링 에이전트” 쪽으로 크게 이동한 모델입니다.특히 제가 보기엔 이번 발표에서 중요한 신호의 순서는:
- Terminal-Bench-Science 24.7 → 52.6%
- 38시간 무인 연구 작업
- 실험실에서 검증된 단백질 binder 설계
- AI가 GPU kernel을 최적화해 생물학 모델을 최대 2.5배 가속
- 4~5년간 인간 엔지니어가 못 찾은 실제 버그 원인 발견
- 에이전트 비용 최대 약 45% 감소
그래서 Amodei식 “AI가 AI 연구와 과학 R&D를 자동화하기 시작한다”는 관점에서 보면, 이번 Fable 5.1에서 가장 중요한 부분은 벤치마크 점수 자체가 아니라
긴 시간 동안 자율적으로 연구 → 실험 → 오류 발견 → 수정 → 재실험하는 루프가 실제 사례에서 나타나기 시작했다는 점입니다.
전체 0