인터뷰/예측
Prime Intellect의 윌 브라운 "지속학습 문제가 2026년 상반기 내에 해결될 수 있다"
작성자
작성일
2026-02-25 18:46
조회
319
호스트: 자, 그럼 지체 없이 Prime Intellect의 윌 브라운(Will Brown)을 모시겠습니다. 안녕하세요? 쇼에 오신 것을 환영합니다, 윌. 어떻게 지내셨나요? 너무 오랜만이네요.
윌 브라운: 아주 잘 지내고 있습니다. 다시 나오게 되어 정말 기쁘네요. 이번이 한 네 번째쯤 되는 것 같네요. 400번째 출연도 기대하고 있습니다.
호스트: 예전 Morgan Stanley 동료들은 현재 기술계의 화두인 '2028년 지능 위기(2028 intelligence crisis)'에 대해 어떻게 생각하고 있나요? 연락 좀 받으셨나요?
윌 브라운: 좋은 질문이네요. 깊게 얘기해보진 않았습니다. 다들 매도 버튼 누르느라 바쁘거든요. 농담이고요, Morgan Stanley 사람들은 모두 Mac Mini를 설정해서 OpenClaw를 실행하느라 바쁠 겁니다. 다들 '무언가 큰일이 일어나고 있다(something big is happening)'는 글을 읽었을 테니까요. 제 생각엔 그 글이 꽤 멋졌다고 봅니다. 내용에 전적으로 동의하는 건 아니지만, 최근 모든 게 미쳐가고 있다는 식의 바이럴 글들보다 사람들이 훨씬 더 흥미로운 대화를 나누게 하는 데 효과적이었다고 생각해요. 대화가 통화 정책, 사람들의 반응, Door Dash 클론을 '바이브 코딩(vibe coding)'으로 만드는 게 얼마나 어려운지 같은 세부적인 내용으로 이어졌죠. 어떤 예측이 맞느냐 틀리냐를 떠나서 세상이 미쳐 돌아갈 때 이런 현실적인 논의를 친구들에게 듣는 건 좋은 현상이라고 봅니다.
호스트: 그렇군요. Prime Intellect의 최신 소식도 전해주세요. 어떻게 지내고 계신가요?
윌 브라운: 네. 흥미로운 일들이 좀 있습니다. 오늘 타임라인에서 일어나고 있는 일들도 이야기하고 싶지만요. 몇 주 전에 저희는 사람들이 최신 오픈소스 모델 위에 자신만의 환경(environment)으로 RL(강화학습)을 아주 쉽게 할 수 있는 학습 플랫폼을 출시했습니다. 저희는 이를 '에이전트 네이티브(agent native)' 경험으로 만들려고 노력했어요.
많은 사람들이 '바이브 RL(vibe RL)'이라는 용어를 쓰며 자신의 경험을 트윗하고 있는데, 이제는 하드웨어나 GPU를 신경 쓰지 않고도 학습을 관리할 수 있는 인프라가 갖춰진 상태에 도달했습니다. 모델이 아직 어려움을 겪는 부분도 있지만, 사용자는 환경과 작업(task)을 설계하고, 원하는 것을 명확히 지정하며, 이미 가지고 있는 데이터를 학습 레시피로 바꾸는 데 집중할 수 있습니다. 사람들이 이런 모델을 꽤 쉽게 학습시킬 수 있는 시점에 왔고, 이를 즐기는 모습을 보는 건 꽤 멋진 일입니다.
호스트: 실제 애플리케이션을 좀 구체화해 보죠. 텍스트나 CLI 도구를 통해 흐름이 진행될 때 가장 잘 작동할 것 같은데요. "좋아, RL 환경을 설정해서 내 워크플로우 하나를 자동화해야지"라고 생각할 때, 라이선스가 있는 Adobe Premiere를 열거나 YouTube에 가서 영상을 다운로드해야 한다면... 예를 들어 우리가 가진 짧은 영상을 편집하는 걸 생각해보면 말이죠.
윌 브라운: 물론입니다. 아주 간단한 것부터 복잡한 것까지 범위가 확실히 있습니다. 하지만 코딩 도구 사용이나 앱 시뮬레이터와 상호 작용하는 스위트 스팟이 많습니다. 완전한 Photoshop보다는 이런 것들이 많은 연구실에서 모델을 훈련하는 사람들의 주요 관심사이기도 하죠. Ramp Labs 팀이 이것을 어떻게 사용했는지 보여주는 아주 멋진 트윗이 있었습니다. 꼭 전체 백엔드를 다 구축할 필요 없이 작업을 포착할 수 있을 정도의 애플리케이션 시뮬레이션을 갖추는 것이 중요합니다. 코딩 에이전트는 사람이 개입하여(human in the loop) CLI 네이티브 환경인 터미널에 들어가 저희 Prime CLI를 사용해 스킬을 설정하고 구성할 수 있을 만큼 충분히 좋습니다. 에이전트에게 "내 데이터는 여기 있고, 앱 코드는 저기 있어. 이걸 다 제자리에 놓고 실행해보자"라고 말하기만 하면 됩니다.
호스트: 개인화된 RL(Personalized RL)로 가는 길은 어느 정도 와 있나요? ChatGPT나 GPT-4에 적용된 RLHF를 생각해보면 수만 명의 계약직 작업자들이 응답을 평가하고, 피드백을 주고, 다양한 수준으로 평가하는 등 매우 대규모의 일반화된 프로세스였잖아요. 만약 제가 중견 기업을 운영하고 있다면, 비즈니스 로그에서 이걸 끌어올 수 있을까요? 아니면 데이터를 생성하기 위해 데이터 라벨링 회사를 고용해야 할까요? 장기적으로는 그냥 화면 녹화기를 켜고 제가 하는 일을 지켜보게 한 다음, RL을 통해 점점 나아져서 프롬프트 하나로 제 일을 대신해 주면 좋겠거든요.
윌 브라운: 꽤 근접해 있습니다. 공상과학 같은 이야기가 아니에요. 텍스트나 이미지 입력, 특히 에이전트 로그에서 나오는 텍스트와 이미지 입력에 초점을 맞춘다면 말이죠. (전체 화면 녹화는 아직 조금 까다롭습니다.) 가장 까다로운 부분은 재시도 시 점수를 매길 때 '무엇이 좋은 것인가'에 대한 기준을 정제하는 것입니다. 하지만 많은 경우 그 기준은 작업 전반에 걸쳐 꽤 일반적이거나 사용자 응답 또는 초기 프롬프트에서 쉽게 추론할 수 있습니다. 우리가 본 바로는 창의적인 글쓰기보다는 매우 구체적인 문제 해결 사용 사례에서 훨씬 더 잘 작동합니다. 정답이 있고 모델이 정답을 맞혔는지 에이전트 기록(사람의 응답이나 제품 사용의 일부로 직원이 라벨링한 내용)을 통해 확인하기가 크게 어렵지 않은 작업의 경우 말이죠. RL 레시피는 안정적이고 확장이 가능해서 항상 완벽하진 않아도 꽤 신뢰할 수 있을 만큼 작동합니다. 진입 장벽과 비용이 사람들이 충분히 시도해 볼 만한 수준까지 내려왔다는 게 멋집니다.
호스트: MCP와 CLI의 논쟁에 대해서는 어떻게 생각하시나요? Peter가 이런저런 논의를 했고, 저도 MCP가 처음 나왔을 때 엄청 멋지다고 생각했어요. 하지만 동시에 프런트엔드에서 요소 검사(inspect element)를 보면 "아, 여기 HTML 요청이 있네. 이걸 리버스 엔지니어링 해보자"하는 느낌도 들었고요.
윌 브라운: 결국 다 비슷한 겁니다. 요청을 보내는 거죠. 사람들은 모델이 코딩을 꽤 잘해서 스킬들이 본질적으로 같은 일을 한다는 걸 깨달았어요. MCP가 가장 유용한 분야는 자격 증명(credentials)이 관련된 미세한 OAuth 처리가 필요할 때입니다. 이 작업이 수행되는지 감지하고 사용자가 특정 요청을 승인하거나 거부하게 하고 싶을 때 '도구 호출(tool call)'이라는 공식적인 형식이 단순한 API 토큰 코드보다 훨씬 유용하죠. 하지만 기능 관점에서는 스킬도 훌륭합니다. MCP도 의미 있는 영역이 있고요. 결국 모델이 컴퓨터를 사용하는 겁니다. 그게 MCP든 코드든 스킬 파일이든 문서를 읽는 것이든 말이죠. 모델은 문서를 꽤 잘 읽고, 무언가를 수행하는 방법에 대한 지침이 있으면 그냥 그 일을 수행할 수 있습니다. 그리고 그게 꽤 유용할 정도로 잘 작동합니다.
호스트: 이 제품이 얼마나 중간자(intermediary)를 거치게 될 거라고 보시나요? 제 말은, 커스텀 파인튜닝 모델이나 RL 모델이 필요한 위젯 회사가 있다고 칠 때, 그들이 직접 윌 씨에게 가지 않고 중간에 SaaS 제품을 제공하는 회사가 익명화된 산업 데이터로 파인튜닝을 하거나 RL을 생성하거나, 아예 그 회사에 가서 "Prime CLI 같은 건 몰라도 됩니다. 데이터만 주시면 우리가 대신 해드릴게요"라고 하는 상황 말입니다.
윌 브라운: 스펙트럼 전반에 걸쳐 확실히 일어날 일입니다. 저희와 가장 직접적으로 일하는 사람들은 좀 더 AI 네이티브한 사람들, 즉 개발자들입니다. 벤치마크를 추적하고, 새로운 모델 출시를 읽고, Claude Code와 에이전트 프레임워크로 구축하는 사람들, 프롬프팅과 평가(evals)에 대해 고민하는 사람들이 주요 타깃이죠. 그래서 저희는 대규모 데이터 회사들과 많이 일하고 있습니다. 한 가지 흥미로운 점은 모두가 환경(environment)을 구축해서 연구소에 팔고 싶어 한다는 겁니다. 그런데 그 회사들은 자신들의 환경이 좋은지 확인하고 싶어 하죠. 그래서 RL을 이 과정의 일부로 사용해 평가하고 기능을 향상시킨다는 걸 증명하는 방법으로 씁니다. 환경을 구축하고 데이터를 다루는 데 전문화된 회사들의 거대한 경제가 형성되어 있습니다. 저는 이것이 최종 기업들이 이런 기술을 소비하는 주요 방식이 될 거라고 생각합니다. 그런 데이터 전문성을 가진 사람들을 통해서요.
호스트: Kimi K2 같은 중국 모델에 대해서는 어떻게 보시나요? 극찬을 본 적도 있지만, 장난감 같은 예제를 넘어서면 완전히 실패한다는 이야기도 들었거든요. 실제 성능은 어떤가요?
윌 브라운: 한 몇 달 정도 뒤처져 있는 건 확실합니다. 4.6이나 CodeX 5.3 수준은 아니지만, 그 이전에 우리가 가졌던 수준에는 꽤 근접해 있어요. 격차가 좁혀지고 있는 것 같습니다. 하지만 제가 가장 흥미롭게 보는 부분은, 이런 모델들이 이미 충분히 좋아서 커스터마이징을 조금만 거치면 특정 분야에서 세계 최고의 모델로 매우 쉽고 빠르게 만들 수 있다는 점입니다. 3개월마다 이 작업을 다시 해야 한다 하더라도, 자신의 데이터를 가져와 최신 모델을 개선하는 이 과정이 정말 쉽고 반복 가능해진다면 거기서 얻을 수 있는 가치가 엄청납니다. 저는 이것이 많은 사람들의 툴킷에 포함될 거라 생각합니다.
오픈소스 모델 전반에 대해서는 오늘 타임라인에서 Anthropic과 DeepSeek, 그리고 증류(distillation)에 관한 흥미로운 논쟁이 있었죠. 지정학적 요소도 있고, 봇 농장이나 스크래핑 같은 서비스 약관 위반 문제도 있고, 증류 자체에 대한 논의도 있습니다. 앞의 두 가지는 이해하지만, 제가 반박하고 싶은 점은 GitHub에 있는 모든 것은 누군가가 Claude에 프롬프트를 입력하고, Claude Code에 제출하고, PR을 리뷰하고 병합한 결과물이라는 겁니다. 이건 완벽한 학습 데이터죠. 인터넷은 완벽한 Claude 증류 학습 데이터로 넘쳐나고 있습니다.
호스트: 흥미롭네요.
윌 브라운: 네, 그리고 그걸 막을 방법은 별로 없어요. 그래서 과연 '증류'가 우리가 목숨을 걸어야 할 문제인지 묻고 싶네요.
호스트: 증류된 모델을 사용할 때 나중에 벽에 부딪히거나 성능에 문제가 생기는 '시한폭탄' 같은 위험은 없을까요? 벤치마크에서는 잘 작동하지만 점차 효과가 떨어지는 게 비즈니스 관점에서 정말 문제가 될까요? 아니면 "3개월 뒤처지지만 비용은 3분의 1이니까 괜찮아"라고 할까요?
윌 브라운: 애플리케이션에 따라 크게 다릅니다. 추출, 요약, 라벨링 같은 다소 일상적인 사용 사례에서는 모델이 이미 충분히 뛰어나기 때문에 단순히 비용이나 속도를 최적화하고 싶어 할 겁니다. 하지만 성능을 최적화하고 싶고 비용이 문제가 안 된다면, 커스터마이징 측면에서 오픈소스 모델이 훨씬 더 흥미로워집니다. 클라우드 모델보다 할 수 있는 게 훨씬 많고, "이게 내 평가(eval)고, 이렇게 성능을 측정할 거야"라며 훨씬 더 세밀한 제어가 가능하니까요. 무엇이 성능을 의미하는지 비즈니스 로직을 정의하는 건 기업의 몫입니다. 구체적으로는 프론티어 모델 중 하나를 메인 오케스트레이터 에이전트로 두고, 특정 비즈니스와 워크플로우에 특화된 수많은 하위 에이전트(파인튜닝된 모델들)를 거느린 다중 에이전트 제품의 형태가 될 겁니다. 이것이 현재 독점 모델과 파인튜닝된 오픈 모델을 섞어 쓰는 가장 지배적인 패러다임이라고 봅니다.
호스트: 1년 전에 누군가에게 "수백만 명의 사람들이 각자의 기술(skills)을 위한 맞춤형 설정과 MD 파일로 로컬에서 에이전트를 실행할 거다"라고 말했다면 꽤 무리한 예측이라고 생각했을 텐데요. 1~2년 뒤에는 사람들이 X(트위터)에서 "내가 특정 문제에 대해 파인튜닝과 RL을 돌렸더니 개인화된 에이전트가 훨씬 좋아졌어"라고 말하는 세상이 올까요?
윌 브라운: 어느 정도는 지금도 볼 수 있습니다. 범위를 잘 좁힌 작업에 대해서는 이런 모델들이 폐쇄형 소스 모델보다 더 나은 성과를 낼 수 있다는 걸 꽤 빨리 증명하는 사람들이 있거든요. 그렇게 어려운 일이 아닙니다. 기본적으로 '바이브 코딩'으로 가능해요. 목표를 영어로 명확히 정의할 수 있고 다들 코딩할 때 쓰는 것과 같은 방식의 프롬프팅을 할 수 있다면, 그냥 연결해서 쓰면 됩니다. 여전히 개념 증명이나 좁은 연구 사례에 가깝긴 하지만, 코딩이 저렴해질수록 환경을 더 복잡하게 만들 수 있습니다. 1년 전 Cloud Code가 처음 나왔을 땐 별로 유용하지 않았죠. 저도 써보고 "너무 지저분하고 혼란스러워서 당장 쓰진 말아야지"라며 Cursor로 돌아갔던 기억이 납니다. 하지만 '이 형태가 언젠가는 작동할 수 있겠다'고 느꼈죠. 1년 전 우리가 가졌던 기술이 이제는 헤비 유저들이 실제 프로덕션 코드 작성에 사용할 수준에 이르렀습니다. 이런 시스템들이 안정화되고, 구조 최적화의 목표가 모델 학습에 다시 반영되는 건 시간문제라고 봅니다.
호스트: 올해 상반기에 실질적인 돌파구가 나올 거라고 예상하시나요? 저희 인턴은 연속 학습(continual learning)을 거의 다 풀었다고 계속 말하고 있는데요.
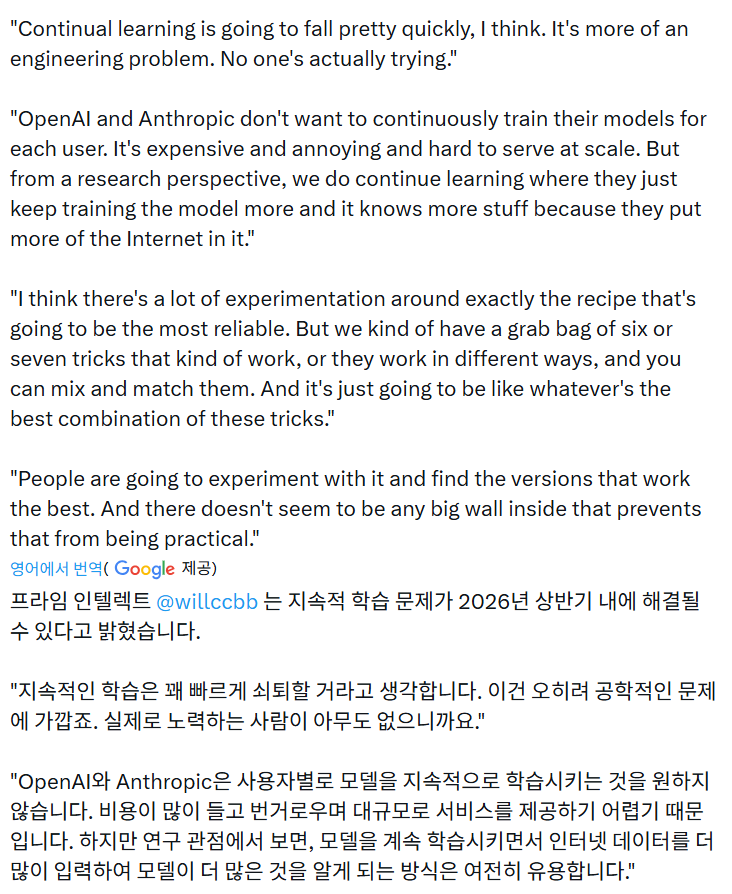
윌 브라운: 네, 연속 학습은 꽤 빨리 정복될 겁니다. 전 이게 리서치 문제라기보다 엔지니어링 문제에 가깝다고 봐요. OpenAI나 Anthropic은 각 사용자마다 모델을 지속적으로 훈련하고 싶어 하지 않아요. 규모를 감당하기 비싸고 성가신 일이니까요. 하지만 모델이 계속 새로운 걸 배우고 인터넷 데이터를 더 넣으면 학습을 지속할 수 있다는 연구 관점에서의 돌파구는 명확합니다.
호스트: 특정 회사(예: McKinsey나 대형 로펌)에게는 "대법원 판결이 완전히 바뀌면 우리 모델은 바로 그날 재학습해서 모든 걸 그걸 바탕으로 해석합니다" 같은 게 엄청난 세일즈 포인트가 될 수 있겠네요.
윌 브라운: 네, 사용할 수 있는 기법(tricks)이 충분히 많아요. 가장 신뢰할 수 있는 레시피에 대한 실험이 많이 이루어지고 있지만, 대략 작동하는 6~7가지 기법의 조합이 있습니다. 사람들은 실험을 통해 가장 잘 작동하는 버전을 찾아낼 겁니다. 이것이 실용화되는 걸 막을 큰 장벽은 보이지 않습니다.
호스트: 칩 하드웨어 쪽은 어떻게 추적하고 계신가요? 저희가 chat.jimmy.ai를 만져보고 있었거든요.
윌 브라운: 그거 정말 멋지죠. 너무 빠르잖아요. 전 얼마나 많은 토큰을 출력할 수 있는지 보려고 "1부터 10,000까지의 숫자를 다 줘"라고 해봤는데, Llama는 프롬프트를 어떻게 주든 몇 천 토큰을 넘어가면 멈추더라고요. 그래서 엄청난 속도로 글이 지나가는 걸 시각적으로 제대로 느끼진 못했습니다.
호스트: Llama 3 8B를 써보니까 그 모델이 처음 나왔을 때 오픈소스 개발자들이 열광했던 기억이 납니다. 하지만 지금의 프론티어 모델을 그런 실리콘(칩)에 굽고 도구 접근 권한과 추론 루프를 준다고 상상해 보세요. 10배만 빨라져도 완전히 다른 경험일 겁니다. "AI는 환각(hallucinate)이 있어서 매번 확인해야 해" 하던 사람들도 "아니, 바로 여기 있고 완벽하고 엄청 빠르게 작동하네"라고 느끼게 될 순간이 올 겁니다. AI 램프 하나 사시겠어요?
윌 브라운: 램프가 옷을 개어준다면요? 제가 맘에 안 들어서 절 토막 낼 확률이 십 분의 일이라도 상관없어요. 전 하드웨어가 정말 기대됩니다. Humane AI Pin이나 Rabbit R1처럼 프론티어 모델이 탑재된 1세대 하드웨어들도 점점 흥미로워지고 있죠. 다음 버전이 잘 나오길 바랍니다. 애플의 전략이기도 한데, 그들은 기능 하나를 기기 내(on-device)에서 충분한 신뢰성으로 구동할 수 있을 때 출시하잖아요. 요약이나 이미지 검색 같은 건 하드웨어와 모델이 좋아져서 이제 기기에서 처리할 수 있죠.
호스트: 칩 크기나 배터리 소모 같은 문제를 해결해야겠지만, 그 지점에 도달하면 정말 재미있고 흥미로운 세상이 오겠네요.
윌 브라운: 네, 미래는 밝습니다. 사람들은 항상 인터넷의 데이터가 고갈될 거라고 말했지만, 우리는 더 많은 데이터를 얻고 있고, 이전 세대 모델에서 생성된 데이터라 품질도 좋습니다. 모델이 좋아질수록 배우기 좋은 데이터가 더 많아지는 플라이휠이 생기는 거죠. 그 위에 RL과 필터링, 인간 데이터를 더해 한 단계 더 끌어올리는 겁니다. 데이터를 더 많이 넣을수록 모델이 향상되는 분명한 경로가 있고, 우리에겐 그 데이터가 있습니다.
호스트: 쇼에 출연해서 인터넷을 위한 데이터를 잔뜩 만들어주셔서 감사합니다. YouTube에 올라갈 테니까요.
윌 브라운: 여러분과 함께 데이터를 생성하게 되어 영광입니다. 학습 데이터 셋에 합류하게 되어 영광이에요.
호스트: 그게 바로 목적이죠. 채팅창에서 인터넷용 데이터를 제공해주시는 모든 분들께도 감사드립니다. 곧 또 뵙겠습니다. 좋은 하루 보내세요!
윌 브라운: 감사합니다. 안녕히 계세요.
앤트로픽 숄토 더글라스도 말한 2026 지속학습의 해
기대되노