최신논문
(2023년 8월) 언어 모델링을 위한 강화된 자기 훈련(ReST)
작성자
작성일
2024-06-25 14:11
조회
474
https://arxiv.org/abs/2308.08998
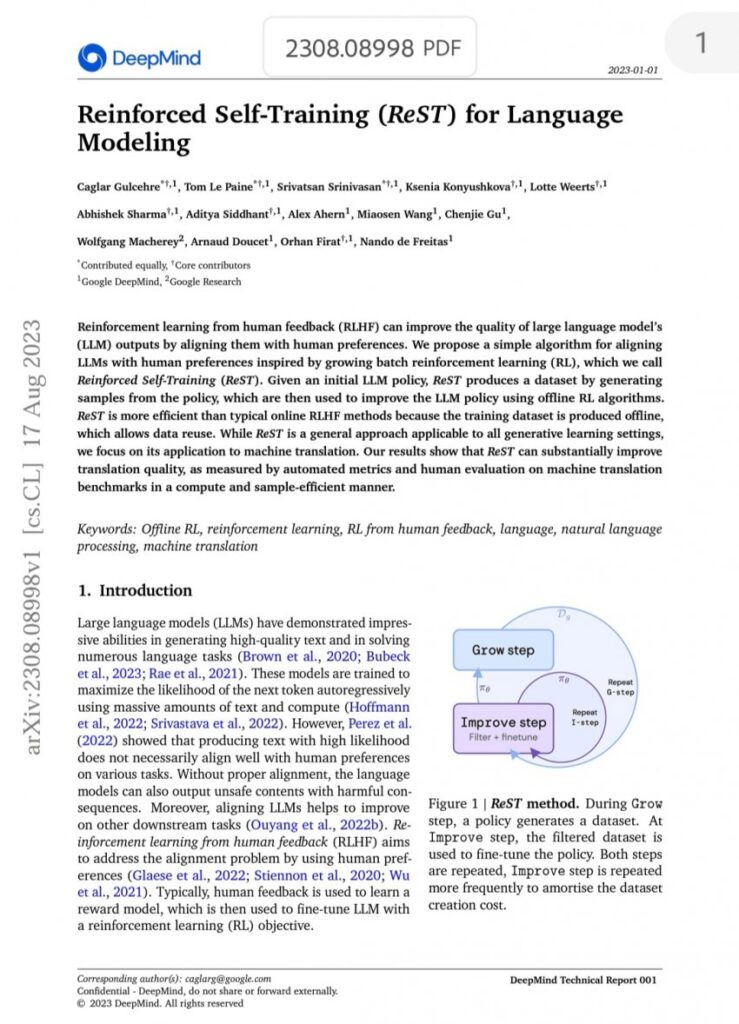
인간 피드백(RLHF)을 통한 강화 학습은 인간 선호도에 맞춰 LLM(대형 언어 모델) 출력의 품질을 향상시킬 수 있습니다. 우리는 ReST(Reinforced Self-Training)라고 하는 일괄 강화 학습(RL)의 성장에서 영감을 받아 LLM을 인간 선호도에 맞추기 위한 간단한 알고리즘을 제안합니다. 초기 LLM 정책이 주어지면 ReST는 정책에서 샘플을 생성하여 데이터세트를 생성합니다. 이 샘플은 오프라인 RL 알고리즘을 사용하여 LLM 정책을 개선하는 데 사용됩니다. ReST는 교육 데이터 세트가 오프라인으로 생성되어 데이터 재사용이 가능하므로 일반적인 온라인 RLHF 방법보다 더 효율적입니다. ReST는 모든 생성 학습 설정에 적용할 수 있는 일반적인 접근 방식이지만 우리는 기계 번역에 적용하는 데 중점을 둡니다. 우리의 결과는 ReST가 컴퓨팅 및 샘플 효율적인 방식으로 기계 번역 벤치마크에 대한 자동화된 지표와 인간 평가를 통해 측정된 번역 품질을 크게 향상시킬 수 있음을 보여줍니다.
인간 피드백(RLHF)을 통한 강화 학습은 인간 선호도에 맞춰 LLM(대형 언어 모델) 출력의 품질을 향상시킬 수 있습니다. 우리는 ReST(Reinforced Self-Training)라고 하는 일괄 강화 학습(RL)의 성장에서 영감을 받아 LLM을 인간 선호도에 맞추기 위한 간단한 알고리즘을 제안합니다. 초기 LLM 정책이 주어지면 ReST는 정책에서 샘플을 생성하여 데이터세트를 생성합니다. 이 샘플은 오프라인 RL 알고리즘을 사용하여 LLM 정책을 개선하는 데 사용됩니다. ReST는 교육 데이터 세트가 오프라인으로 생성되어 데이터 재사용이 가능하므로 일반적인 온라인 RLHF 방법보다 더 효율적입니다. ReST는 모든 생성 학습 설정에 적용할 수 있는 일반적인 접근 방식이지만 우리는 기계 번역에 적용하는 데 중점을 둡니다. 우리의 결과는 ReST가 컴퓨팅 및 샘플 효율적인 방식으로 기계 번역 벤치마크에 대한 자동화된 지표와 인간 평가를 통해 측정된 번역 품질을 크게 향상시킬 수 있음을 보여줍니다.
전체 0